带视觉能力的 GGUF 模型——Local AI 多模态入门
多模态 GGUF 是什么
普通 GGUF 模型只能处理文本。带视觉能力的 GGUF(VL 架构)额外包含了一个图像处理模块——输入是图片 + 文本 prompt,输出是基于图片内容的文字描述或回答。
Local AI 对多模态的支持有两个前提:
- 你装的 GGUF 本身就是 VL 架构(比如 Qwen2-VL、SmolVLM、LLaVA)
- 图片以设备本地文件的形式送入(不会上传到任何服务器)
怎么判断一个 GGUF 能不能识图
从魔搭社区下载时,模型名通常会明确标注:
| 关键词 | 含义 | 示例 |
|---|---|---|
| VL | Vision-Language | Qwen2-VL-2B |
| VLM | Vision Language Model | SmolVLM-2B |
| LLaVA | 经典视觉模型架构 | LLaVA-v1.6-7B |
普通文本模型的名字里没有这些标识——比如 Qwen2.5-3B、Llama-3.2-3B 都是纯文本。
推荐的视觉模型
手机端内存有限,视觉模型建议从 2B 起步:
| 模型 | 参数量 | 最低内存 | 中文识图 | 说明 |
|---|---|---|---|---|
| Qwen2-VL | 2B | 6 GB | 强 | 中文原生,识票据、读截图都好用 |
| SmolVLM | 2B | 6 GB | 一般 | 轻量快速,适合英文场景 |
| LLaVA-v1.6 | 7B | 12 GB+ | 一般 | 经典视觉模型,体验好但吃内存 |
装完怎么用
模型就绪后,对话页输入框旁边会出现一个图片按钮(📷 或 + 号):
- 点击图片按钮 → 从相册选图或拍照
- 图片会显示在对话输入区
- 在下方输入文字 prompt(比如"解释这张图片里的内容")
- 发送,模型会在本地分析图片并回复
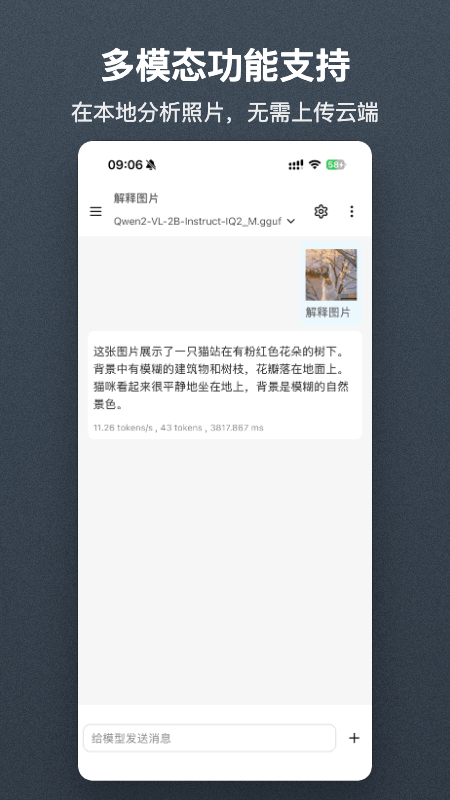
多模态识图的局限
- 速度慢:视觉模型的推理比纯文本模型慢很多(通常 20~30 token/s 起步)
- 识图精度有限:手机端 2B 模型能识别大概内容,但精细细节(小字、复杂图表)容易出错
- 不支持复杂格式:当前只支持常规图片格式(PNG/JPG),PDF 等需要先转图
- 内存占用更高:视觉模型比同参数量的纯文本模型大——因为包含了图像处理模块