Local AI 到底是什么——离线大模型手机运行器解析
运行器的角色
Local AI 本体不带任何模型。它的定位是一个通用运行器——负责把你选中的 GGUF 模型文件在手机上加载、推理、输出。模型是谁、多大、跑多快,全部由用户自己决定。
这样的设计带来三个直接好处:
- 模型自由:不受限于应用内置的单一模型,Qwen、DeepSeek、Llama、Gemma 等主流系列的 GGUF 版本都能装
- 体积可控:应用本体约 193 MB,模型按需下载,不用的删掉释放空间
- 社区跟随:新模型、新量化档位一出来就能用,不用等应用更新
核心能力一览
离线推理
飞行模式下照常对话。推理引擎基于 llama.cpp 的安卓适配版,全程在手机 SoC 上跑。输入、输出、会话设置没有任何环节经过云端。
GGUF 精细调优
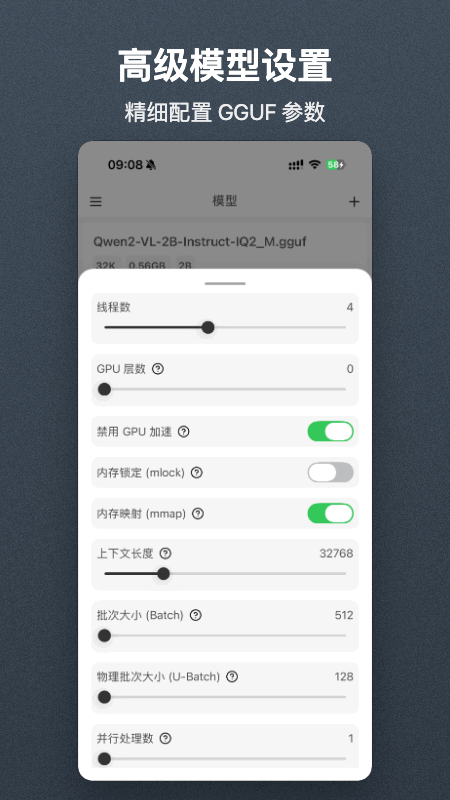
不满足于默认参数的玩家可以手动调整 GPU 层数、内存锁定、批次大小、并行数——把每 GB 内存和每帧算力用在刀刃上。
多模态识图
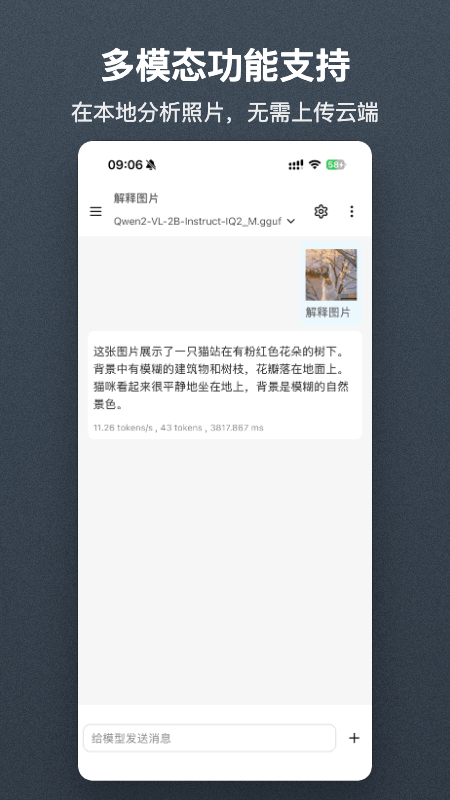
搭配带视觉能力的 GGUF 模型(如 Qwen2-VL),照片在本地完成识别与描述——图片不离开设备,无网络环境同样可用。
对话参数自由配置
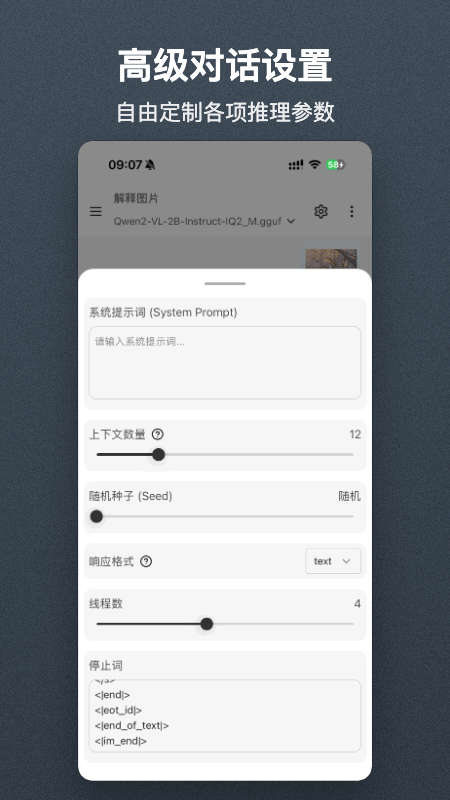
系统提示词、上下文轮数、随机种子、线程数、停止词——推理前的关键变量全部摆在面前。想要稳定的复现输出还是发散的创意回答,调完再开聊。
它不是什么
Local AI 不是通用 AI 助手应用。它不会自动帮你联网搜索、不会帮你打电话发短信、不会在后台常驻。它做的事情很单一:加载一个 GGUF 模型,在本地接收 prompt、生成回复。
这意味着它不适合两类人:需要云端大模型算力的用户、希望开箱即用不想折腾模型参数的用户。如果你需要"装上就能用、不用自己选模型"的体验,可以看看其他产品。
与同类应用的区别
| 对比项 | Local AI | 云端大模型 App | PC 端 Ollama / LM Studio |
|---|---|---|---|
| 推理位置 | 安卓手机本机 | 云端服务器 | PC 本机 |
| 联网依赖 | 仅下载模型时需要 | 全程需要 | 仅下载模型时需要 |
| 隐私边界 | 对话不出本机 | 对话经云端 | 对话不出本机 |
| 模型来源 | GGUF(开源通用格式) | 闭源商业模型 | GGUF、Original |
| 硬件门槛 | 6 GB 内存起步 | 无(云端算力) | 16 GB 内存起步 |