魔搭社区一键下载 GGUF 模型
为什么用魔搭社区
Local AI 内置了与魔搭社区(ModelScope)的直连接口,这是目前国内下载开源 GGUF 模型最顺畅的通道——国内服务器、下载速度稳定、热门中文模型齐全(Qwen、DeepSeek 等都优先上架)。
操作路径
- 打开 Local AI,进模型管理页(底部导航栏或侧边栏)
- 点右上角 + 按钮,选择「从社区下载」
- 在模型列表里按内存筛选:
- 6 GB 内存:筛参数量 1B~2B
- 8 GB 内存:筛参数量 2B~3B
- 12 GB 内存:筛参数量 4B~7B
- 找到满意的模型后点进去,选择量化档位(从 Q4_K_M 起步)
- 点下载,等进度走完
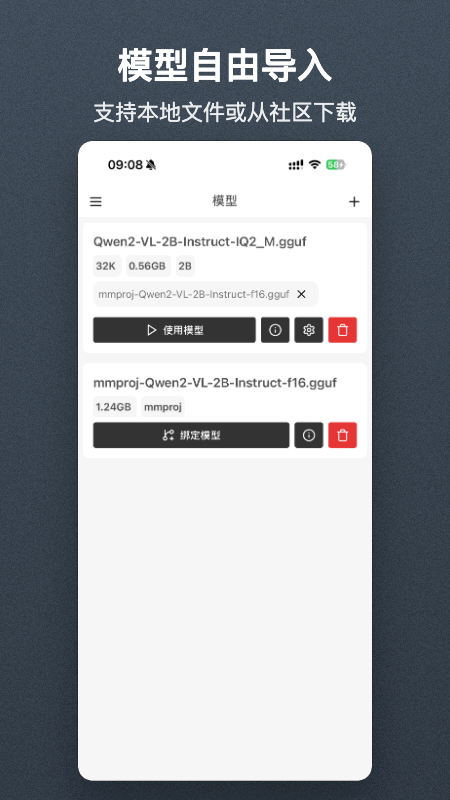
下载时看什么信息
模型详情页会展示几个关键数据:
- 参数量:比如 2B、7B,对应模型规模。直接匹配你的内存档位
- 文件大小:下载前就能看到。Wi-Fi 环境下再下
- 量化档位:Q4_K_M / Q5_K_M 等,影响体积和质量
- 架构:llama、qwen2、gemma2 等,通常不用改,社区会给对应 GGUF 版本
推荐起步模型
如果你不确定选哪个,从下面三个里挑一个就行:
| 模型 | 参数量 | 适用内存 | 中文能力 | 说明 |
|---|---|---|---|---|
| Qwen2.5 | 1.5B / 3B | 6~8 GB | 强 | 中文原生,日常问答首选 |
| DeepSeek-R1-Distill | 1.5B / 3B | 6~8 GB | 强 | 蒸馏自 R1,推理任务表现好 |
| Qwen2-VL | 2B | 6~8 GB | 强 | 带视觉能力,可识图(需要多模态) |
下载中断怎么办
网络不稳可能导致下载中断。此时:
- 模型管理页找到那个半下载的条目,点删除
- 重新从社区下载
- 不要尝试修复中断的文件——损坏的 GGUF 加载一定会失败
下载完成后
状态会从「下载中」自动变为「就绪」。此时你可以:
- 进对话页直接开始聊
- 去模型设置页调整 GPU 层数、内存策略等参数(高级玩家)
- 装更多模型以备切换